100万量子ビット。
この数字を聞いて、皆さんは何を想像するでしょうか。
手のひらに収まる超高性能チップでしょうか。
それとも、巨大なスーパーコンピュータでしょうか。
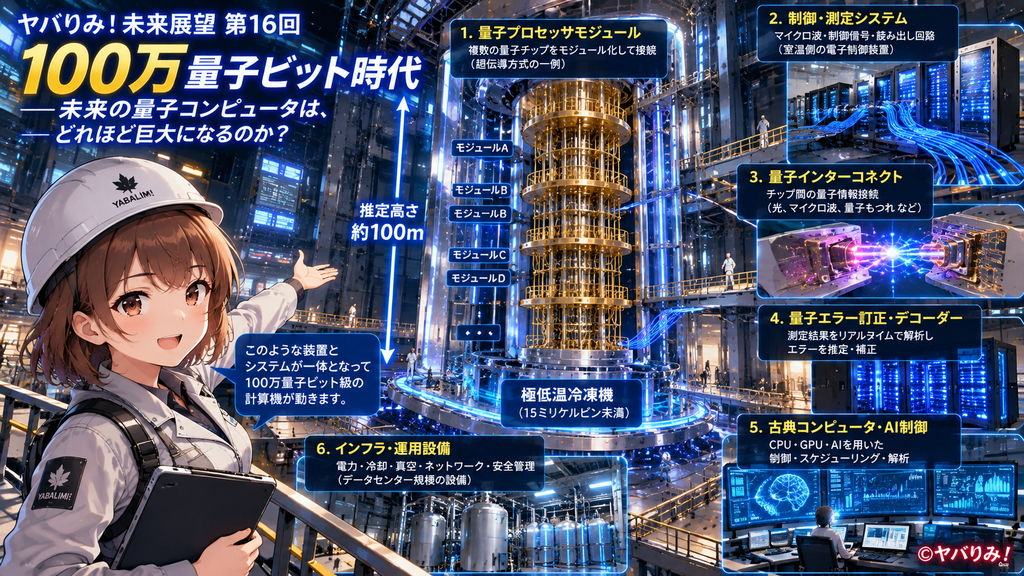
実は、未来の量子コンピュータを考えるとき、チップの大きさだけを見ても、その全体像は分かりません。
量子ビットを冷却する装置。
膨大な信号を伝える配線。
量子状態を読み取る測定装置。
エラーを瞬時に解析する古典コンピュータ。
そして、それらを統合して動かす制御システム。
これらすべてが必要になります。
しかも、量子ビットが100万個になれば、それだけで100万個分の有用な計算能力が得られるわけではありません。
重要なのは、どれだけ多くの量子ビットを、どれだけ正確に、どれだけ長く動かせるのかという問題です。
今回は、あかりと一緒に未来の量子コンピュータの内部へ入ってみましょう。
研究室の小さな量子チップから、巨大な量子データセンターへ。
その未来は、すでに工学上の具体的な課題として研究されています。
- 100万量子ビットとは何か?――数字の意味を最初に整理する
- 量子チップを100個並べれば、巨大な量子コンピュータになるのか?
- IBMが実証した、巨大な極低温システムへの一歩
- 100万量子ビットを冷却する――最大の問題は温度だけではない
- 冷却しない量子コンピュータもあるのか?
- 日本の研究が示した、別の拡張方法
- 100万量子ビットを制御するのは、実は古典コンピュータかもしれない
- AIは巨大な量子コンピュータの制御を担うのか?
- 巨大化の本当の壁――空間、時間、そして古典計算資源
- Magic State Factory――量子コンピュータの内部に、もう一つの工場が必要になる
- 世界の開発競争――何が実証され、何がまだ目標なのか
- 量子データセンターの建設費は、いくらになるのか?
- 100万量子ビットは、必ずしも最適な目標ではない
- 2030年代、私たちは量子コンピュータを所有するのか?
- 量子コンピュータの未来を判断する、五つの指標
- 未来の量子コンピュータは、一つの巨大な機械ではないかもしれない
- 次回予告
- 参考資料・一次情報
100万量子ビットとは何か?――数字の意味を最初に整理する
最初に、非常に重要な違いがあります。
**物理量子ビット(Physical Qubit)と論理量子ビット(Logical Qubit)**です。
物理量子ビットは、超伝導回路、原子、イオン、光などを使って実際に実装される量子情報の基本単位です。
一方、論理量子ビットは、量子エラー訂正によって保護された情報の単位です。
例えば、1,000個の物理量子ビットがあっても、エラー訂正に多くの量子ビットを使用するなら、利用可能な論理量子ビット数は1,000個より少なくなります。
ただし、ここで「物理量子ビット100個で論理量子ビット1個」といった固定の換算をしてはいけません。
必要な物理量子ビット数は、採用する量子エラー訂正符号、物理エラー率、要求する論理エラー率、計算時間、演算方法などによって変わります。
Surface Code(表面符号)では、符号距離を大きくすると保護に必要な物理量子ビット数が概ね距離の二乗に比例して増えます。ただし、補助量子ビット、境界、論理演算、状態準備などの費用を含めると、単純な二乗だけではシステム全体を表せません。
また、qLDPC(量子低密度パリティ検査符号)などでは、より高い符号化率によって空間的な負担を減らせる可能性があります。
しかし、空間的な負担が減っても、接続や測定、論理演算の難しさが残る場合があります。
つまり、
100万個の物理量子ビットを搭載した機械と、100万個の論理量子ビットで計算できる機械は、まったく別の目標なのです。
さらに、100万量子ビットがすべて利用可能な状態にあっても、それだけで実用的な量子計算が保証されるわけではありません。
量子ビットの品質、接続性、ゲート精度、測定精度、計算速度、エラー訂正の処理能力まで確認する必要があります。
これからの量子コンピュータ競争では、単なる量子ビット数よりも、実際にどの規模の計算を、どの信頼性で実行できたかが重要になります。
量子チップを100個並べれば、巨大な量子コンピュータになるのか?
例えば、1万量子ビットを持つ量子プロセッサを100個用意したとします。
合計は100万量子ビットです。
では、これらを並べれば、100万量子ビットの量子コンピュータが完成するのでしょうか。
答えは、そう簡単ではありません。
量子計算では、量子ビット同士の相互作用が必要になります。
異なるチップに存在する量子ビットを使って共同で計算するには、チップ間で量子情報をやり取りしたり、量子もつれを生成したりする仕組みが必要です。
しかも、その操作にもエラーが発生します。
チップ間の接続が遅ければ、量子ビットが待機している間にエラーが蓄積するかもしれません。
接続精度が低ければ、せっかく各チップ内で量子情報を保護しても、チップ間の演算が計算全体の弱点になります。
さらに、100個のチップを接続できたとしても、それらを自由自在に同時制御できるとは限りません。
重要になるのは、次のような設計上の問題です。
- チップ間でどのように量子もつれを作るのか。
- 接続に必要な時間とエラー率はどれほどか。
- 量子エラー訂正をチップ間でも維持できるのか。
- 計算処理を各チップへどう割り当てるのか。
- 一部の接続が故障したとき、計算全体をどう守るのか。
これは、単にプロセッサを増やす問題ではありません。
複数の量子プロセッサを、一つの信頼できる計算システムとして動かす問題です。
ここで注目されているのが、モジュール型量子コンピュータという考え方です。
一枚の巨大な量子チップを作る代わりに、複数の比較的小さな量子モジュールを接続し、全体として計算能力を拡張していきます。
ただし、モジュール化は問題を消す魔法ではありません。
チップ内部の問題の一部を、チップ間通信やシステム統合の問題へ移すことにもなります。
どちらの設計が有利かは、ハードウェアの方式や実行する計算によって変わります。
IBMが実証した、巨大な極低温システムへの一歩
2026年8月19日、IBMは量子コンピュータの大規模化に向けた重要な発表を行いました。
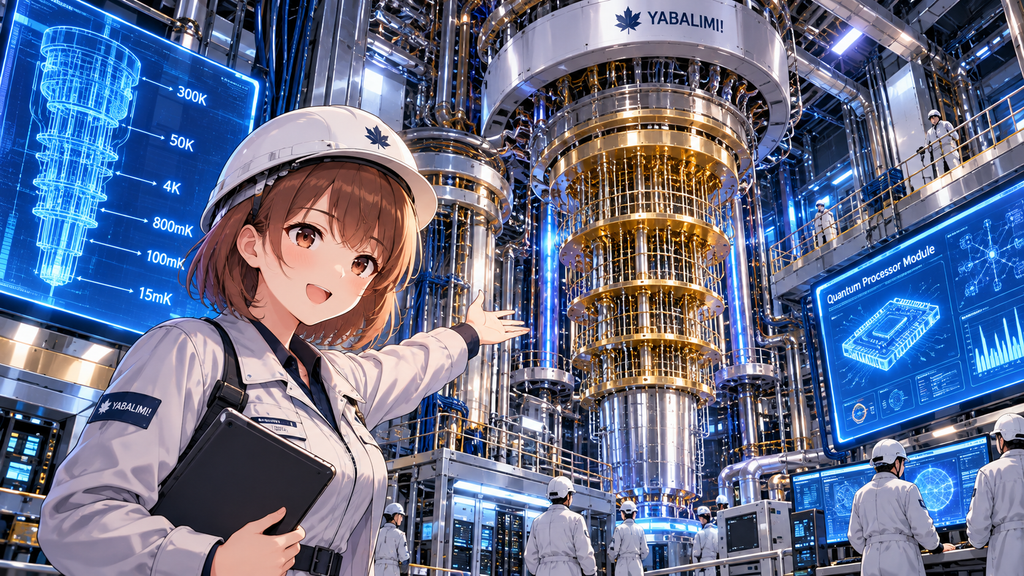
2つの極低温モジュールを接続し、共通の極低温環境として冷却することに成功したというものです。
IBMによると、接続された2つのモジュールは、高さ・幅ともに8フィートを超える規模です。
初期試験では、5日未満で4ケルビンまで冷却し、その後、15ミリケルビン未満に到達したと報告されています。
15ミリケルビンとは、絶対零度よりわずか0.015度高い温度です。
一般的な室温とは比較にならないほど低温です。
なぜ、これほど冷却する必要があるのでしょうか。
超伝導量子ビットでは、量子状態を維持し、熱による不要な励起を抑えるために極低温環境が重要になります。
ただし、量子ビットの動作周波数や構造によって事情は異なり、15ミリケルビンという数字だけで量子ビットの品質が決まるわけではありません。
また、冷凍機の温度と、実際に量子ビットが経験するすべての雑音環境も同一ではありません。
重要なのは、IBMが冷却温度だけでなく、複数の量子プロセッサを接続するための物理的な空間とシステム構造に取り組んでいる点です。
発表によると、新しいモジュールの真空容器には、従来広く使われてきたIBMの量子システムと比較して最大12倍の配線スペースが設けられています。
また、L-couplerと呼ばれる接続技術によって、別々の量子チップ間で情報を共有する構想も進めています。
IBMは2027年までに、複数プロセッサを接続し、少なくとも1,000個のプログラム可能な量子ビットを持つシステムを目指すとしています。
ここは明確に区別する必要があります。
2026年8月に実証されたのは、極低温モジュールの接続と冷却です。100万量子ビットの計算機が完成したわけではありません。
さらに、冷却モジュールを接続できることと、その内部に多数の高品質な量子ビットを搭載してエラー訂正付きの計算を実行できることも、別々の達成段階です。
それでも、この成果には意味があります。
巨大な量子コンピュータを作るためには、量子チップの外側にある装置そのものを、拡張可能な構造へ変える必要があるからです。
100万量子ビットを冷却する――最大の問題は温度だけではない
ここで、少し意外な事実があります。
超伝導量子コンピュータを巨大化する際、問題になるのは、単に冷凍機の内部を冷やせるかどうかだけではありません。
低温環境へ何を、どれだけ持ち込むかが重要になります。
量子ビットを制御するには、マイクロ波などの信号を送る必要があります。
測定結果を取り出すための経路も必要です。
しかし、室温の電子機器と極低温の量子チップをつなぐ配線は、熱を持ち込む経路にもなります。
信号を増やし、配線を増やし、測定経路を増やせば、冷凍機の熱設計はさらに難しくなります。
量子ビットの数を10倍にしたとき、配線や装置の負担も単純に10倍になるとは限りません。
制御信号を共有できる設計もあれば、個別制御が必要な部分もあります。
信号の多重化によって配線を減らす研究もありますが、同時操作数、信号干渉、読み出し速度、故障時の影響などとの交換条件が生じます。
つまり、未来の巨大な超伝導量子コンピュータでは、
量子チップ、冷凍機、配線、制御回路を別々に最適化するだけでは不十分なのです。
システム全体を同時に設計する必要があります。
さらに、冷凍機の冷却能力には温度段ごとの制約があります。
極低温段に許される熱負荷と、室温側で必要な電力は別の数字です。
「量子チップ自体の消費電力が小さいから、量子コンピュータ全体も省電力になる」と考えるのは早計です。
冷却装置、制御電子回路、古典コンピュータ、ネットワーク設備などの電力も必要だからです。
冷却しない量子コンピュータもあるのか?
ここまで読むと、量子コンピュータはすべて巨大な極低温冷凍機の中で動くように思えるかもしれません。
しかし、量子コンピュータには複数の実装方式があります。
代表的なものを比較してみましょう。
| 方式 | 量子情報の主な担い手 | 大規模化で重要な課題 |
|---|---|---|
| 超伝導方式 | 超伝導回路 | 極低温、配線、制御、接続 |
| イオントラップ方式 | 電磁場に閉じ込めたイオン | イオンの輸送、光学制御、演算速度 |
| 中性原子方式 | 光で捕捉した原子 | 原子配列、レーザー制御、測定、モジュール間接続 |
| 光量子方式 | 光子 | 光損失、光源、検出器、誤り耐性 |
| 半導体スピン方式 | 電子などのスピン | 製造ばらつき、配線、制御、低温動作 |
この表で重要なのは、極低温冷凍機を必要としない方式でも、装置全体が単純になるとは限らないことです。
例えば中性原子方式では、原子を捕捉するための光学系や真空装置が必要です。
また、光量子方式では、光子そのものは極低温の超伝導回路と同じ条件を必要としなくても、高性能な光子検出器などに冷却が必要になる場合があります。
各方式には異なる強みと制約があります。
現時点で、100万量子ビット規模の実用的な汎用量子コンピュータに最も適した方式が、最終的に一つへ確定したとは言えません。
日本の研究が示した、別の拡張方法
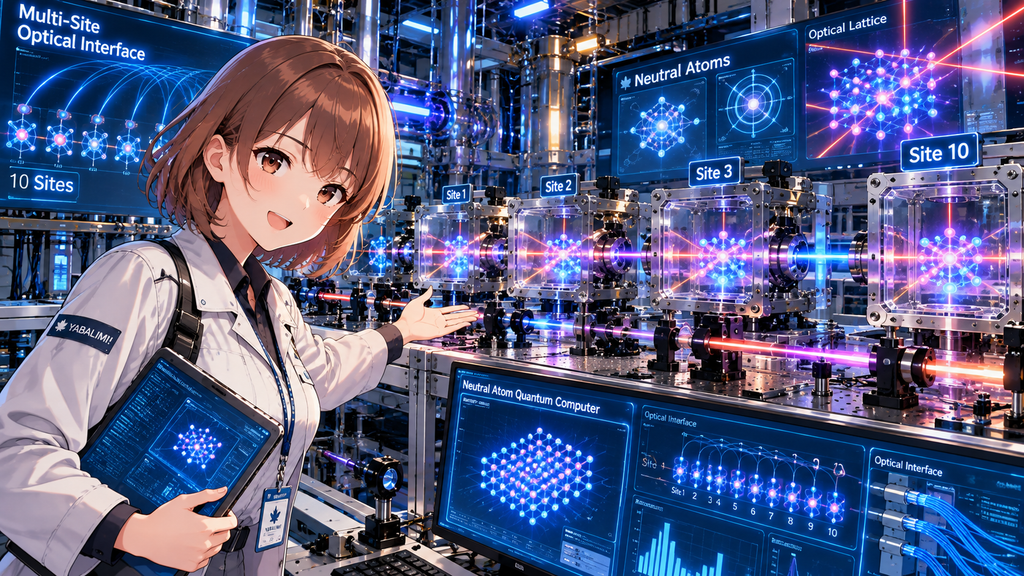
2026年9月1日、大阪大学、科学技術振興機構、情報通信研究機構などの研究グループは、大規模中性原子量子コンピュータに向けた多重量子光インターフェースの研究成果を発表しました。
この研究では、10サイトでの空間多重化の検証に成功しています。
研究グループは、集積光導波路アレイを用いて、原子から放出された光子を並列に取り出し、光ファイバーを通して検出する技術を示しました。
なぜ、この研究が重要なのでしょうか。
中性原子量子コンピュータでは、多数の原子を配列させることができます。
しかし、さらに巨大な量子コンピュータを作るには、一つの原子アレイを無制限に大きくする以外の方法も必要になります。
そこで考えられるのが、複数の量子プロセッサを光によって接続する構想です。
異なる装置間で量子もつれを利用できれば、離れた量子モジュールを協調させる道が開けます。
ただし、ここでも慎重に区別しなければなりません。
今回の成果は、10サイトの多重光インターフェースの実証です。
10個の量子コンピュータを接続して、完成した誤り耐性型量子計算を実行したという意味ではありません。
また、研究グループが示した100多重程度への拡張可能性は、今後の研究方向を示すものであり、実証済みの100多重システムと同じではありません。
光子の取り出し効率、損失、量子もつれ生成の成功率、接続速度、計算中のエラー訂正など、解決すべき課題は残ります。
それでも、この成果は、量子コンピュータを巨大化する方法が一つではないことを示しています。
IBMが極低温モジュールの接続を進める一方、日本の研究グループは光を利用した接続技術を前進させています。
将来の量子コンピュータは、単一の巨大チップではなく、多数の量子モジュールを接続した分散型の計算機になる可能性があります。
100万量子ビットを制御するのは、実は古典コンピュータかもしれない
量子コンピュータという名前から、すべての処理を量子ビットが担当すると考える人もいるでしょう。
しかし、実際には古典コンピュータの役割が極めて重要です。
量子ビットへ送る制御信号の生成。
測定データの収集。
量子エラー訂正のための情報処理。
次に実行する操作の決定。
量子回路のコンパイル。
システム全体の監視。
こうした処理には古典的な電子回路やコンピュータが使われます。
特に重要なのが、量子エラー訂正のデコーダーです。
量子エラー訂正では、量子情報そのものを無造作に測定するのではなく、エラーに関する情報を取得します。
この情報は、シンドロームと呼ばれます。
デコーダーは、そのシンドロームから、どのようなエラーが起きた可能性が高いかを推定します。
その結果をもとに、補正操作を実行したり、後続の演算で解釈を調整したりします。
重要なのは、必ずしも毎回すべてのエラーを物理的に打ち消す必要があるわけではないという点です。
Pauli Frameと呼ばれる考え方では、補正情報を古典側で追跡し、必要に応じて後の操作や測定結果へ反映できます。
しかし、どのような方法を採用しても、処理能力と遅延の問題は残ります。
量子ビットが増え、エラー訂正の測定を繰り返すほど、処理するデータ量も増えます。
特に、量子計算の次の操作が直前の測定結果に依存する場合、古典処理の遅延が計算速度を制限する可能性があります。
これは非常に重要な問題です。
量子プロセッサの性能だけを高めても、古典デコーダーが追いつかなければ、システム全体の性能は十分に向上しないからです。
AIは巨大な量子コンピュータの制御を担うのか?
ここでAIの出番です。
量子コンピュータでは、量子ビットの状態や制御条件が時間とともに変化する場合があります。
装置のわずかな変動が、演算精度に影響することもあります。
こうした変化を検出し、制御パラメータを適切に調整することは重要な研究課題です。
機械学習や強化学習は、量子プロセッサの較正や制御の改善に利用できる可能性があります。
しかし、AIがあれば量子エラー訂正が不要になるわけではありません。
AIによる較正、リアルタイムデコーダー、量子エラー訂正符号は、それぞれ異なる役割を担います。
また、AIによる最適化そのものにも計算資源が必要です。
高度な学習モデルを量子コンピュータの制御ループへ組み込む場合、推論速度、処理の確実性、異常時の安全性、古典計算資源の消費などを考える必要があります。
将来の巨大な量子コンピュータでは、AIが重要な補助技術になる可能性があります。
ただし、どの制御処理にAIが最適なのか、どの部分は専用電子回路や従来型アルゴリズムで処理する方がよいのかは、個別に検証する必要があります。
AIと量子コンピュータを組み合わせれば、すべてが自動的に高速化するわけではないのです。
巨大化の本当の壁――空間、時間、そして古典計算資源
ここまで見てきた課題を、もう一段深く整理しましょう。
巨大なフォールトトレラント量子コンピュータの設計では、少なくとも三つの負担を同時に考える必要があります。
第一は、**空間的な負担(Space Overhead)**です。
必要な物理量子ビット数、補助量子ビット数、チップ面積、配線、冷却装置などが関係します。
第二は、**時間的な負担(Time Overhead)**です。
エラー訂正の繰り返し、論理演算、測定、量子ビットの移動、モジュール間通信などに必要な時間です。
第三は、**古典処理の負担(Classical Processing Overhead)**です。
シンドローム処理、デコード、制御信号の生成、計算のスケジューリングなどが含まれます。
これらは互いに独立していません。
例えば、物理量子ビット数を節約できる符号を採用しても、論理演算が複雑になれば、計算時間や接続の負担が増える可能性があります。
反対に、物理量子ビットを多く使用する設計でも、局所的な接続によって実装が容易になり、制御の安定性を確保しやすい場合があります。
したがって、未来の量子コンピュータの性能を比較するときには、
「何個の量子ビットを使ったか」
だけでは足りません。
必要な計算を完了するまでに、どれだけの物理資源、時間、古典計算能力が必要だったのか。
これを評価する必要があります。
Magic State Factory――量子コンピュータの内部に、もう一つの工場が必要になる
さらに、巨大な量子コンピュータには、一般にはあまり知られていない重要な設備が必要になる可能性があります。
**Magic State Factory(マジック状態工場)**です。
フォールトトレラント量子計算では、エラーから保護された論理量子ビットを作るだけでは、任意の量子計算を実行できません。
量子計算を普遍的に実行するためには、Clifford演算だけでなく、非Clifford演算が必要になります。
多くの量子エラー訂正方式では、この非Clifford演算を信頼性高く実行することが難しい課題になります。
その解決方法の一つが、特殊な量子状態であるMagic Stateを準備し、計算へ利用する方法です。
しかし、十分な品質のMagic Stateを得るために、複数の不完全な状態から高品質な状態を作る蒸留処理が必要になる場合があります。
これには、追加の量子ビットと演算時間が必要です。
しかも、必要なMagic Stateの数は、実行するアルゴリズムによって大きく異なります。
そのため、ある計算では論理量子ビットを保持するための設備が中心になる一方、別の計算ではMagic Stateを供給する設備が大きな割合を占める可能性があります。
ここで、100万量子ビットという数字の見方が変わります。
その100万個のうち、実際にアルゴリズムのデータを保持するために使われるのは何個でしょうか。
エラー訂正に使われるのは何個でしょうか。
Magic Stateの生成や蒸留に使われるのは何個でしょうか。
計算のために一時的に必要になる補助量子ビットは何個でしょうか。
量子ビットの総数だけでは、計算機の本当の能力は分からない理由が、ここにもあります。
なお、非Clifford演算の実現方法はMagic Stateだけではありません。ハードウェアや符号の設計によって、別の方式も研究されています。
世界の開発競争――何が実証され、何がまだ目標なのか
量子コンピュータの開発競争では、企業ごとに異なる指標が発表されています。
物理量子ビット数。
論理量子ビット数。
ゲート忠実度。
量子回路の実行規模。
エラー訂正性能。
これらを同じ数字として単純比較することはできません。
例えばIBMは、2029年に「IBM Quantum Starling」と呼ばれるフォールトトレラント量子コンピュータを実現する計画を公表しています。
同社の目標は、200論理量子ビットで1億量子ゲート規模の回路を実行することです。
また、2033年以降には、より多くの論理量子ビットを備えるシステムへの拡張を構想しています。
ただし、2029年の性能は企業が掲げる将来目標であり、2026年時点ですでに達成された性能ではありません。
また、IBMの構想では、qLDPC系の量子エラー訂正符号も重要な役割を担っています。
ここで注目したいのは、IBMが単に物理量子ビットを増やすのではなく、モジュール化、エラー訂正、デコード、論理演算を統合する計画を進めていることです。
一方、日本の研究機関も、光接続などの基盤技術を研究しています。
米国では超伝導、イオン、中性原子、光量子など複数の方式で開発が進み、欧州や中国でも量子プロセッサや量子通信、誤り耐性技術の研究が行われています。
ただし、方式や企業によって公開される評価指標は異なります。
2026年10月時点で、世界のどこかに100万論理量子ビットを備えた汎用フォールトトレラント量子コンピュータが完成したと判断できる公開実証は確認できません。
将来計画の大きさではなく、実際に公開された実験内容を見極める必要があります。
量子データセンターの建設費は、いくらになるのか?
ここからは、技術の話を少し離れ、経済性を考えてみましょう。
もし100万量子ビット級の計算機を建設するとしたら、費用はいくら必要なのでしょうか。
この問いに対して、現時点で信頼できる一律の金額を示すことは困難です。
なぜなら、100万量子ビットといっても、方式や装置構成によって必要な設備が大きく変わるからです。
超伝導方式であれば、極低温システム、制御電子回路、配線、量子チップ、古典計算資源などが必要です。
中性原子方式では、光学系、レーザー、真空装置、原子の捕捉・操作・測定設備が重要になります。
光量子方式では、光源、光回路、検出器、光損失への対策などが費用を左右します。
さらに、量子コンピュータの建設費だけでなく、継続的な運用費も考える必要があります。
装置の保守。
較正。
故障部品の交換。
電力。
冷却。
研究開発と専門人材。
古典計算システム。
これらが総費用に影響します。
ここで注意したいのは、量子コンピュータの消費電力を、量子ビット数だけから計算することはできないという点です。
量子ビット一個あたりの消費電力という単純な換算では、システム全体のエネルギー消費を適切に表せません。
また、量子コンピュータが将来、特定の問題を古典コンピュータより少ない演算回数で解けるようになったとしても、必ず総電力消費が少なくなるとは限りません。
装置全体の電力と、問題を解くための総実行時間を含めた比較が必要です。
経済性を評価するには、最終的に、
一つの有用な問題を解くために、どれだけの時間と費用が必要か
を見なければなりません。
100万量子ビットは、必ずしも最適な目標ではない
ここで、さらに踏み込んだ疑問があります。
そもそも、100万量子ビットを目指すこと自体が、正しいのでしょうか。
量子コンピュータの価値は、量子ビット数が大きいことだけでは決まりません。
例えば、同じ計算を実行する場合でも、量子アルゴリズムの改善によって必要な論理量子ビット数が減るかもしれません。
量子エラー訂正符号の改善によって、必要な物理量子ビット数が減る可能性もあります。
より高速な論理演算や効率的なMagic Stateの生成によって、実行時間が短くなるかもしれません。
反対に、量子ビットを大量に搭載していても、エラー率が高く、論理演算が遅ければ、実用的な計算を完了できない場合があります。
つまり、量子コンピュータの開発は、
「どれだけ多くの量子ビットを搭載できるか」
という競争から、
「目的の計算を実行するために、必要な資源をどれだけ減らせるか」
という競争へ進む可能性があります。
この視点では、100万量子ビットという数字は、完成を示すゴールではありません。
大規模な量子計算機を考えるための、一つの規模の目安なのです。
2030年代、私たちは量子コンピュータを所有するのか?
では、将来、私たち一人ひとりが量子コンピュータを所有する時代は来るのでしょうか。
もちろん、将来の技術進歩を完全に予測することはできません。
しかし、大規模な量子コンピュータが高価な冷却設備、精密制御装置、特殊な測定機器、専門的な運用体制を必要とするなら、一般家庭へ普及するより、専用施設で集中運用される可能性があります。
その場合、利用者はインターネットを通じて量子計算資源へアクセスすることになります。
すでに量子クラウドという考え方は実用的な研究環境として存在しています。
ただし、将来の大規模量子コンピュータが、現在のクラウドサービスとまったく同じ形で提供されるとは限りません。
計算の性質によっては、古典スーパーコンピュータとの緊密な連携が必要になるでしょう。
CPUやGPUが得意な処理は古典側で実行し、量子プロセッサが有利になる可能性のある処理だけを量子側へ送る。
そのようなハイブリッド型の計算環境が重要になると考えられます。
ここで、ヤバりみ!未来展望シリーズの最初に取り上げた「ハイブリッド時代」というテーマへ戻ってきます。
未来の計算機は、古典コンピュータが量子コンピュータに置き換わるという単純な構図ではないのかもしれません。
異なる計算技術が、それぞれの強みを生かして協力する。
その中に、巨大な量子計算施設が組み込まれる可能性があるのです。
量子コンピュータの未来を判断する、五つの指標
これから世界の量子コンピュータ開発に関するニュースを読むとき、次の五つに注目してみてください。
1.物理量子ビット数と論理量子ビット数
搭載した量子ビットの総数だけでなく、どれだけの量子情報をエラーから保護できるのか。
2.論理エラー率
エラー訂正を行った後でも、どれくらいの確率で論理的な失敗が発生するのか。
3.論理演算の性能
量子情報を保持するだけでなく、信頼できる論理ゲートをどの程度実行できるのか。
4.システム全体の資源消費
量子ビット、計算時間、デコード、冷却、制御などにどれほどの資源が必要なのか。
5.実際に完了した計算
研究成果が、量子ビットの保存実験なのか、限定的な論理演算なのか、それとも実用的な問題を解く計算なのか。
この五つを区別するだけでも、量子コンピュータのニュースをかなり正確に理解できるようになります。
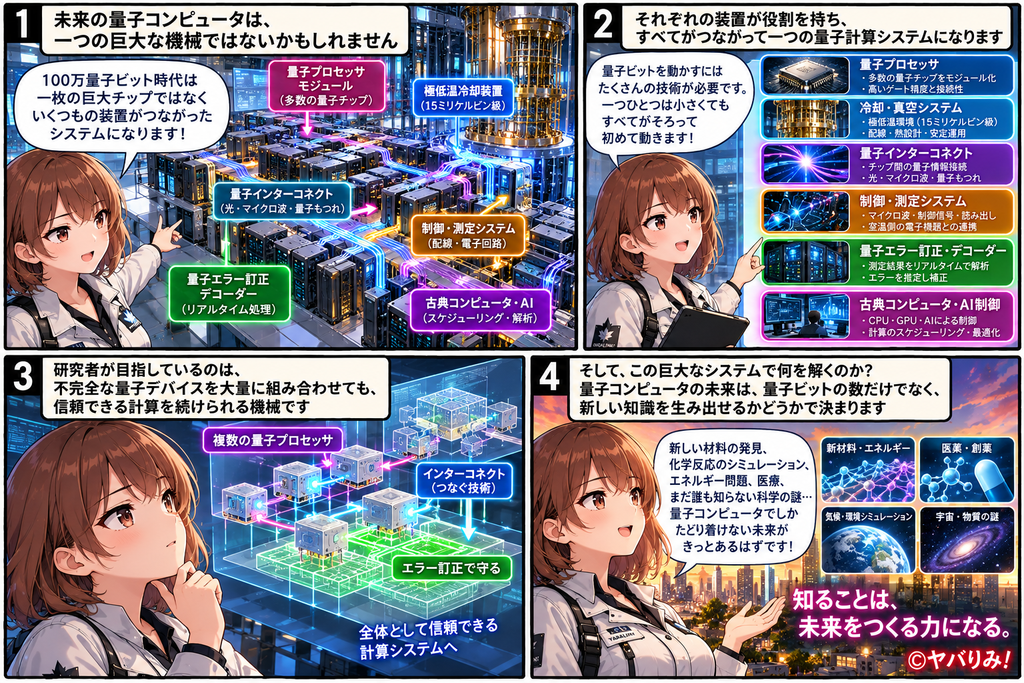
未来の量子コンピュータは、一つの巨大な機械ではないかもしれない
100万量子ビット時代。
その姿は、私たちが想像する巨大な一枚のチップとは異なるかもしれません。
複数の量子プロセッサ。
それらをつなぐ量子インターコネクト。
精密な冷却装置や光学設備。
膨大な測定情報を処理する古典コンピュータ。
量子エラー訂正のための専用デコーダー。
必要な論理演算を支える量子状態の生成設備。
そして、システム全体を調整する制御ソフトウェア。
これらが一体となって、ようやく一つの量子計算システムになります。
研究者が解決しようとしているのは、単に量子ビットを増やすことではありません。
不完全な量子デバイスを大量に組み合わせても、全体として信頼できる計算を続けられる機械を作ること。
そこに、未来の量子コンピュータ開発の本質があります。
そして、この巨大なシステムが完成に近づくほど、もう一つの問題が重要になります。
その計算能力を、実際に何へ使うのでしょうか。
新しい材料の発見でしょうか。
化学反応の精密なシミュレーションでしょうか。
それとも、まだ私たちが十分に想像できていない科学の問題でしょうか。
量子コンピュータの未来を決めるのは、量子ビットの数だけではありません。
その計算機でしか到達できない、新しい知識を生み出せるかどうか。
本当の価値は、そこにあるのかもしれません。
次回予告
ヤバりみ!未来展望 第17回|量子コンピュータは何を計算するのか?――科学を変える「本当に役立つ問題」の正体
量子コンピュータが巨大化し、エラーを訂正できるようになったとしても、それだけでは社会に価値は生まれません。
次回は、量子化学、材料科学、分子シミュレーションなどを中心に、量子コンピュータが古典計算を上回る可能性のある問題を掘り下げます。
理論上の高速化と、実際に産業で役立つ計算は何が違うのか。
「量子コンピュータなら何でも速い」という誤解を整理しながら、本当に重要な応用分野を探ります。
関連記事|ヤバりみ!未来展望 第15回
100万量子ビットの巨大な計算機を実現するには、量子ビットを増やすだけでなく、計算中に発生するエラーを訂正し続ける技術が欠かせません。
その仕組みと最新研究については、前回の記事で詳しく解説しています。
▶ 第15回|量子コンピュータは「壊れながら計算する」時代へ――フォールトトレラント量子計算の現在地
参考資料・一次情報
- IBM Newsroom(2026年8月19日)
IBM Connects Its First Modular Cryogenic Systems in Milestone Toward Fault-Tolerant Quantum Computing
https://newsroom.ibm.com/2026-08-19-ibm-connects-its-first-modular-cryogenic-systems-in-milestone-toward-fault-tolerant-quantum-computing - 大阪大学・JST・NICT(2026年9月1日)
「大規模中性原子量子コンピュータ向けの多重量子光インターフェースを実現」
https://www.nict.go.jp/press/2026/09/01-1.html - IBM Quantum(2025年6月10日)
How IBM will build the world’s first large-scale, fault-tolerant quantum computer
https://www.ibm.com/quantum/blog/large-scale-ftqc - IBM Quantum — Hardware and Roadmap
IBM Quantum Starling、モジュール型量子計算、量子中心型スーパーコンピューティングに関する公式資料。
https://www.ibm.com/quantum/hardware - IBM Quantum Roadmap
量子ハードウェア、エラー訂正、論理量子ビット、将来の開発目標に関する公式ロードマップ。
https://www.ibm.com/roadmaps/quantum/
本記事は2026年10月時点の公開研究・公式発表をもとに構成しています。研究成果、将来計画、技術的な可能性は区別して記述しています。
コメント